用 Astro 内容集合管理博客文章
从 schema 校验、目录约定到构建期过滤,记录内容集合在个人博客里的实际用法与取舍。
本文目录
内容集合(Content Collections)解决的问题很具体:把散落在目录里的 Markdown 变成有类型、可校验、可查询的数据。对个人博客来说,它的价值不在“功能多”,而在“坏数据会在构建期失败”。
为什么需要内容集合
没有 schema 的时候,frontmatter 只是一段 YAML。字段拼错、日期写成中文、标签随意新增,都要等到页面上出现空白时才被发现。内容集合把这些检查提前到构建阶段,并给出具体字段名。
目录与图片
文章以目录为单位,图片与正文放在一起。这样迁移时不需要额外维护一份资源映射,相对路径也不会因为文章换位置而失效。
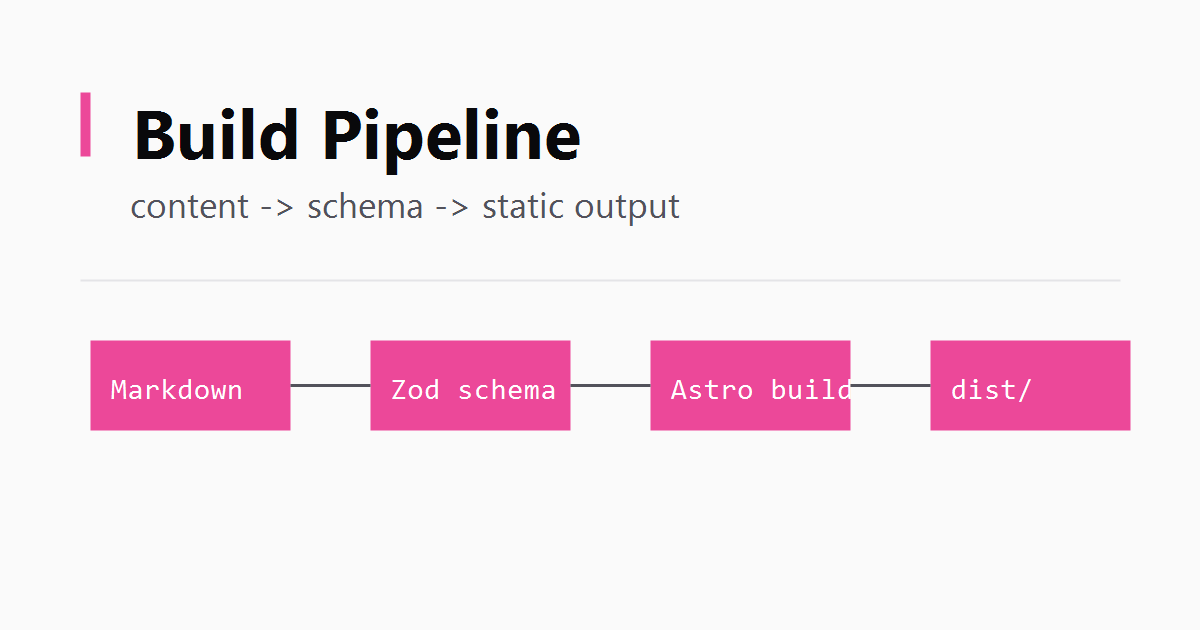
schema 示例
下面是一段刻意加长的代码,用来检查代码块的横向滚动与复制按钮:
export const blog = defineCollection({
  loader: glob({ base: './src/content/blog', pattern: '**/index.{md,mdx}' }),
  schema: ({ image }) => z.object({
    title: z.string().min(1).max(80),
    description: z.string().min(20).max(160),
    slug: z.string().regex(/^[a-z0-9]+(?:-[a-z0-9]+)*$/),
    pubDate: z.coerce.date(),
    tags: z.array(z.enum(tagNames)).max(3).default([]),
    draft: z.boolean().default(false),
    cover: image().optional(),
  }),
});
字段对照
| 字段 | 必填 | 类型 | 默认值 | 校验规则 | 用途 | 示例 | 备注 |
|---|---|---|---|---|---|---|---|
| title | 是 | string | — | 1–80 字符 | 标题与 SEO | 你好,世界 | 中文建议不超过 40 字 |
| description | 是 | string | — | 20–160 字符 | 摘要与 meta | 一篇示例文章 | 必须能独立成立 |
| slug | 是 | string | — | kebab-case | URL | hello-world | 全局唯一 |
| pubDate | 是 | date | — | 可解析日期 | 排序与 RSS | 2026-10-18 | 按站点时区过滤 |
| updatedDate | 否 | date | — | ≥ pubDate | 更新时间 | 2026-10-20 | 不替换发布日期 |
| tags | 否 | string[] | [] | 注册表内 | 分类 | 前端 | 最多 3 个 |
| draft | 否 | boolean | false | — | 草稿过滤 | true | 构建时排除 |
| cover | 否 | image | — | 本地图片 | 封面 | /uploads/astro-content-collections-cover.png | 需同时提供 coverAlt |
构建期过滤
草稿与未来日期在构建时被排除,因此它们不会进入首页、列表、RSS 或搜索索引。日期按 Asia/Shanghai 的日历日比较,避免 YYYY-MM-DD 被解析成 UTC 午夜后,在当天早上被误判为未来。1
小结
内容集合不是银弹,但它把“内容约定”变成了可执行代码。对一个人维护的博客来说,这比多一套后台更有用。
Footnotes
-
具体实现见
src/lib/posts.ts中的isPublished()。 ↩
讨论
评论由 GitHub Discussions 提供,点击后加载。未加载前不会产生第三方请求。